
Kan AI kandidaten matchen zonder bias in het proces?
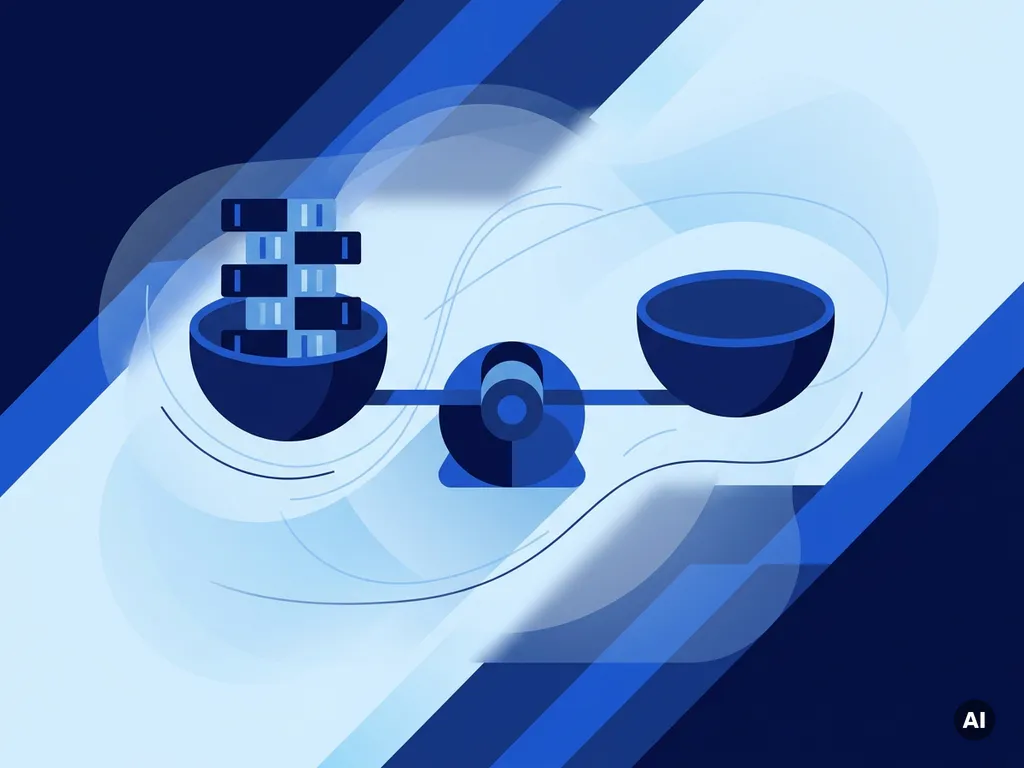
Ja, AI kan kandidaten matchen zonder bias in het proces, maar alleen als het systeem bewust is ontworpen om vooroordelen te voorkomen. De kwaliteit van de trainingsdata en de transparantie van het algoritme zijn daarbij doorslaggevend. Hoe dat in de praktijk werkt, en welke vragen je moet stellen voordat je AI-matching inzet, lees je hieronder.
Hoe ontstaat bias in AI-matchingsystemen?
Bias in AI-matchingsystemen ontstaat wanneer het algoritme leert van historische data die al bevooroordeeld waren. Als een systeem is getraind op de profielen van mensen die in het verleden zijn aangenomen, neemt het de patronen uit die selecties over, inclusief de blinde vlekken van de recruiters die die keuzes maakten.
Dat klinkt technisch, maar het mechanisme is eenvoudig. Stel dat een bedrijf de afgelopen tien jaar vooral mannen in technische functies heeft aangenomen. Een AI die op die data traint, leert dat “technisch profiel” gelijkstaat aan “mannelijk profiel”. Niet omdat het systeem dat zo bedoelt, maar omdat de data dat patroon bevat.
Er zijn drie hoofdbronnen van bias in AI-matchingsystemen:
- Historische bias: de trainingsdata weerspiegelt ongelijke kansen uit het verleden
- Meetbias: bepaalde kenmerken worden verkeerd of onvolledig gemeten, waardoor het systeem op de verkeerde signalen optimaliseert
- Feedbackbias: het systeem leert van zijn eigen eerdere aanbevelingen, waardoor fouten zich versterken in plaats van corrigeren
Bias is dus geen fout die je er achteraf uithaalt. Het zit ingebakken in hoe het systeem is gebouwd en wat het heeft geleerd. Daarom is transparantie over de trainingsdata en het matchingsproces geen luxe, maar een basisvereiste.
Welke vormen van bias komen het meest voor bij AI-werving?
De meest voorkomende vormen van bias bij AI-werving zijn genderbias, afkomstbias en confirmatiebias. Genderbias en afkomstbias ontstaan door ongelijke representatie in trainingsdata. Confirmatiebias treedt op wanneer het systeem kandidaten aanbeveelt die lijken op mensen die eerder zijn aangenomen, zonder die aanname te bevragen.
Naast deze drie zijn er nog andere vormen die minder zichtbaar zijn, maar even invloedrijk:
- Adressen en postcodes: sommige systemen gebruiken locatiedata als proxy voor sociaaleconomische achtergrond
- Naamherkenning: namen met een niet-westerse klank scoren in sommige systemen lager, ook als alle andere criteria gelijk zijn
- Opleidingsbias: een systeem dat prestige van scholen meeweegt, filtert indirect op achtergrond in plaats van op competentie
- Taalbias: kandidaten die niet in perfect formeel Nederlands schrijven, worden soms lager gerangschikt, ook als hun inhoudelijke kwalificaties sterk zijn
Wat deze vormen gemeen hebben: ze zijn niet altijd zichtbaar in de output. Het systeem geeft een score of een ranking, maar de redenering erachter blijft verborgen. Dat maakt controle moeilijk, tenzij het systeem expliciet is ontworpen om die redenering inzichtelijk te maken.
Wat is het verschil tussen blinde screening en onbevooroordeelde AI?
Blinde screening verwijdert identificerende informatie zoals naam, geslacht of leeftijd uit een kandidaatprofiel. Onbevooroordeelde AI gaat verder: het systeem is zo gebouwd dat het niet op die kenmerken optimaliseert, ook niet indirect via variabelen die ermee correleren. Blinde screening is een maatregel; onbevooroordeelde AI is een ontwerpprincipe.
Het onderscheid is belangrijk, omdat blinde screening een vals gevoel van veiligheid kan geven. Je verwijdert de naam, maar het systeem gebruikt nog steeds de universiteit, de schrijfstijl of de postcode, variabelen die sterk correleren met achtergrond. Het resultaat is bias met een extra stap ertussen.
Onbevooroordeelde AI vereist drie dingen die verder gaan dan het weglaten van gegevens:
- Bewuste keuze van welke variabelen het systeem mag gebruiken bij het matchen
- Regelmatige audit van de outputpatronen, niet alleen de inputdata
- Transparantie over de matchingslogica, zodat een mens de redenering kan controleren
Een systeem dat alleen op competenties en functie-eisen matcht, zonder historische aannamepatronen als leerfactor, komt dichter bij onbevooroordeeld dan een systeem dat simpelweg een naam wegstreept.
Hoe kan AI bias in het wervingsproces juist verminderen?
AI kan bias in het wervingsproces verminderen door menselijke inconsistentie te vervangen door gestructureerde, herhaalbare criteria. Een mens beoordeelt de ene kandidaat anders op een vrijdagmiddag dan op een dinsdagochtend. Een goed gebouwd systeem past dezelfde logica toe op elke kandidaat, elke keer.
Dat is een reëel voordeel, maar het werkt alleen als de criteria zelf neutraal zijn. De kracht van AI zit niet in het elimineren van alle subjectiviteit, maar in het zichtbaar maken ervan. Als het systeem transparant is over waarom een kandidaat hoog scoort, kan een recruiter die redenering toetsen en bijsturen.
Concreet kan AI bias verminderen op de volgende manieren:
- Gestandaardiseerde functie-eisen als basis voor matching, in plaats van “gevoel” of “cultural fit”
- Geautomatiseerde outreach naar een breder kandidatenbestand, inclusief passieve kandidaten die anders over het hoofd worden gezien
- Consistente opvolging van elke kandidaat, zodat respons niet afhankelijk is van wie er toevallig dienst heeft
- Inzichtelijke scoring, zodat de recruiter begrijpt waarom een kandidaat wordt aanbevolen
De module Reach van talentix werkt op basis van dit principe: multichannel outreach in de eigen merkstijl van de klant, waarbij elke reactie op dezelfde manier wordt geclassificeerd. Niet de recruiter die op gevoel beslist wie een follow-up krijgt, maar een systeem dat dat consequent doet voor elke kandidaat.
Welke vragen moet je stellen voordat je AI-matching inzet?
Voordat je AI-matching inzet, moet je minimaal drie vragen beantwoorden: op welke data is het systeem getraind, welke variabelen gebruikt het bij het matchen, en wie is verantwoordelijk als de output aantoonbaar ongelijk uitpakt. Zonder duidelijke antwoorden op deze vragen is de kans groot dat je bias automatiseert in plaats van elimineert.
Hieronder staan de vragen die je concreet aan een leverancier kunt stellen:
- Op welke trainingsdata is het systeem gebouwd, en hoe divers is die data?
- Welke kenmerken gebruikt het algoritme bij het rangschikken van kandidaten?
- Kan ik de matchingslogica inzien per kandidaat?
- Hoe wordt het systeem geaudit op ongelijke uitkomsten?
- Wie is verantwoordelijk bij een discriminerende aanbeveling: de leverancier of de klant?
Die laatste vraag is geen juridische formaliteit. Onder de EU AI Act, die in 2026 steeds meer tanden krijgt, vallen AI-systemen die worden ingezet bij werving in de categorie “hoog risico”. Dat betekent dat transparantie en menselijk toezicht geen opties zijn, maar vereisten.
Een systeem dat je die vragen niet kan beantwoorden, is geen systeem dat je wilt inzetten voor iets wat zo bepalend is als wie je aanneemt. Kies voor een platform dat de redenering laat zien, de mens in de beslissing houdt en gebouwd is met die verantwoordelijkheid als startpunt, niet als bijgedachte.
Wil je zien hoe talentix transparantie en controle combineert in een volledig geautomatiseerd wervingsproces? Bekijk dan hoe het Hiring OS werkt.
Laatst bijgewerkt: juni 2026
Meer uit deze categorie
Welke 5 AI-tools zijn onmisbaar voor talent acquisition?
Ontdek welke 5 AI-tools talent acquisition in 2026 transformeren en hoe je de juiste kiest.
Hoe prioriteer je 200 kandidaten met AI-matching?
AI-matching prioriteert 200 kandidaten automatisch op relevantie. Ontdek hoe je controle houdt over de uitkomst.
Hoe verkort AI de doorlooptijd van een recruitmentpipeline?
AI verkort een recruitmentpipeline van weken naar dagen. Ontdek hoe dat precies werkt.