
Welke data gebruikt AI talent sourcing om kandidaten te identificeren?
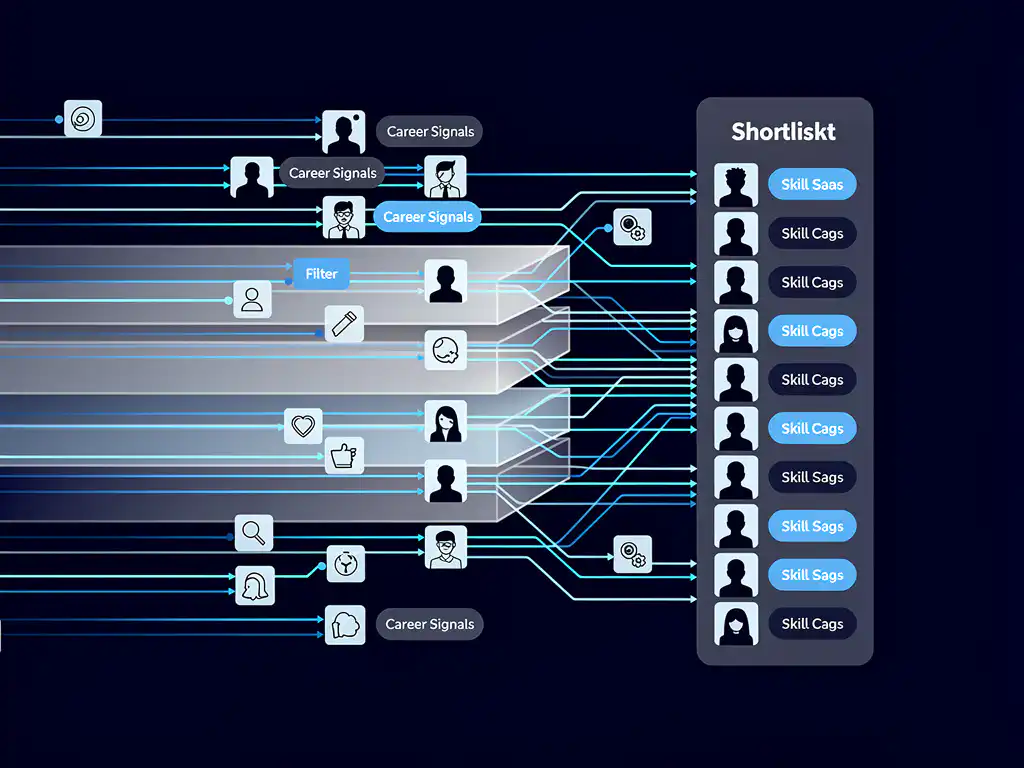
AI talent sourcing combineert data uit meerdere bronnen tegelijk om kandidaten te identificeren die niet actief solliciteren. Het systeem koppelt openbare profieldata, gedragssignalen en interne vacature-informatie aan elkaar om een nauwkeurig beeld te vormen van wie relevant is en waarom. De secties hieronder beantwoorden de meest gestelde vragen over hoe dat proces werkt.
Kernpunten uit dit artikel:
- AI talent sourcing put uit minimaal vier databronnen tegelijk, van openbare profielen tot intentiesignalen, om kandidaten te rangschikken op relevantie in plaats van beschikbaarheid.
- Het onderscheid tussen first-party en third-party data bepaalt niet alleen de matchkwaliteit, maar ook de AVG-compliance van het hele proces.
- De uiteindelijke kwaliteit van een kandidaatmatch staat of valt met de kwaliteit van de intake: garbage in, garbage out geldt ook voor AI-gedreven werving.
Welke databronnen combineert AI talent sourcing?
AI talent sourcing combineert doorgaans vier categorieën databronnen: openbare professionele profielen (zoals LinkedIn), vacature- en functietiteldata, bedrijfsinformatie over werkgevers en concurrenten, en interne data zoals eerdere sollicitaties of CRM-records. De combinatie van deze bronnen geeft het systeem context die één bron nooit alleen kan bieden.
Openbare profielen leveren de basisinformatie: functietitels, werkervaring, opleiding en vaardigheden. Maar een profiel op zichzelf zegt weinig over geschiktheid voor een specifieke rol. Pas wanneer dat profiel wordt gecombineerd met informatie over de organisatie waar iemand werkt, de grootte van dat bedrijf, de sector en recente carrièrebewegingen, ontstaat er een volledig beeld.
Daar bovenop komen gedragsdata en signalen van buiten de profielen zelf. Denk aan publicaties, bijdragen aan communities, spreken op evenementen of zichtbare projecten. Deze laag helpt het systeem onderscheid te maken tussen iemand die toevallig de juiste titel heeft en iemand die ook inhoudelijk actief is in het vakgebied.
Tot slot speelt de vacature zelf een rol als databron. De functie-eisen, de bedrijfscultuur, de locatie en de uitsluitingscriteria vormen samen het zoekprofiel waaraan alle externe data wordt getoetst. Hoe rijker die interne informatie, hoe gerichter het systeem kan zoeken.
Hoe verwerkt AI ongestructureerde kandidaatdata?
AI verwerkt ongestructureerde kandidaatdata door middel van natural language processing (NLP): het systeem leest tekst, herkent patronen en vertaalt die naar gestructureerde attributen zoals functieniveau, sector, vaardigheidsclusters en loopbaanfase. Daardoor kan het werken met profielen die niet uniform zijn opgebouwd.
Niet elke kandidaat vult zijn profiel op dezelfde manier in. De ene persoon schrijft gedetailleerde functieomschrijvingen, de andere noemt alleen een jobtitel. AI-systemen zijn getraind om beide te begrijpen en te normaliseren. Een “Senior Data Engineer” bij een scale-up en een “Lead Engineer Data Platforms” bij een corporate kunnen door het systeem als vergelijkbare profielen worden herkend, ook al klinken de titels anders.
Hetzelfde geldt voor vaardigheden. Iemand die schrijft over het bouwen van datapipelines in Python hoeft dat niet expliciet als vaardigheid te hebben gelabeld. Het systeem leidt het af uit de context. Die inferentie is waardevol, maar ook een risicofactor: als de trainingsdata beperkt of eenzijdig is, kunnen systematische fouten ontstaan in hoe profielen worden geïnterpreteerd.
Wat zijn intentiesignalen en hoe herkent AI ze?
Intentiesignalen zijn gedragsindicatoren die erop wijzen dat een kandidaat openstaat voor een nieuwe stap, ook zonder actief te solliciteren. AI herkent ze door patronen te analyseren in profielwijzigingen, activiteit op platforms en zichtbare carrièrebewegingen. Een profiel dat plotseling wordt bijgewerkt na een lange periode van stilte is een klassiek voorbeeld.
Andere signalen zijn subtieler. Iemand die zijn “open to work”-status niet heeft ingeschakeld maar wel recent zijn vaardigheidssectie heeft uitgebreid, geeft een zwak maar relevant signaal. Iemand die na vijf jaar bij dezelfde werkgever opeens actief begint te reageren op posts van andere bedrijven, geeft een sterker signaal.
AI combineert meerdere zwakke signalen tot een waarschijnlijkheidsscore. Geen enkel signaal is op zichzelf doorslaggevend. De kracht zit in de combinatie: een recent bijgewerkt profiel, een langere tenure bij de huidige werkgever dan gemiddeld in de sector, en activiteit in communities rondom een nieuw vakgebied samen suggereren dat iemand klaar is voor een volgende stap.
Belangrijk is dat intentiesignalen altijd een aanname blijven. Ze verhogen de trefkans van een benadering, maar vervangen niet de menselijke beoordeling of het gesprek.
Welk verschil maakt first-party data ten opzichte van third-party data?
First-party data is informatie die een organisatie zelf heeft verzameld, zoals eerdere sollicitanten, medewerkers of contacten uit eigen netwerken. Third-party data is afkomstig van externe bronnen zoals databrokers of platforms. Het verschil is fundamenteel: first-party data is betrouwbaarder, actueler en juridisch eenvoudiger te gebruiken.
Third-party data heeft een inherent versheidsprobleem. Tegen de tijd dat een databroker een profiel heeft samengesteld en verkocht, kan de informatie al maanden oud zijn. Functies zijn veranderd, contactgegevens kloppen niet meer, en de context ontbreekt. Dat verhoogt het aantal mismatches en verlaagt de respons op outreach.
First-party data heeft een ander voordeel: context. Een kandidaat die twee jaar geleden heeft gesolliciteerd en toen net niet paste, kan nu precies de juiste persoon zijn. Die historische relatie is waardevoller dan een koud profiel van een onbekende. Organisaties die investeren in het opbouwen en onderhouden van hun eigen talentpool plukken daar op de lange termijn de vruchten van.
Voor AI talent sourcing betekent dit dat de kwaliteit van de output direct samenhangt met de kwaliteit en volledigheid van de beschikbare first-party data. Systemen die alleen op third-party bronnen draaien, missen die diepte.
Hoe blijft AI talent sourcing AVG-compliant bij het verzamelen van data?
AI talent sourcing blijft AVG-compliant door uitsluitend te werken met openbaar beschikbare data, een duidelijke grondslag te hebben voor verwerking (zoals gerechtvaardigd belang voor werving), transparant te zijn over hoe data wordt gebruikt, en kandidaten altijd de mogelijkheid te bieden zich te laten verwijderen uit het systeem.
De AVG stelt dat persoonsgegevens alleen mogen worden verwerkt als daar een rechtmatige grondslag voor is. Bij talent sourcing is dat doorgaans “gerechtvaardigd belang”: een werkgever heeft een legitiem belang bij het vinden van kandidaten voor een openstaande functie. Maar dat belang moet worden afgewogen tegen de privacy van de kandidaat, en de verwerking moet proportioneel zijn.
Concreet betekent dit dat systemen geen gegevens langer mogen bewaren dan nodig, geen gevoelige categorieën mogen verwerken zonder expliciete toestemming, en kandidaten actief moeten informeren wanneer hun gegevens worden gebruikt. Voor Europese organisaties is het extra relevant om te werken met platforms die data binnen de EU verwerken, zodat doorgifte aan derde landen buiten de EER niet aan de orde is.
talentix verwerkt alle data binnen de EU en is gebouwd met de AVG en de EU AI Act als uitgangspunt. Dat is een concreet voordeel ten opzichte van Amerikaanse platforms die data buiten de EER verwerken en daarmee extra juridische risico’s meebrengen voor Nederlandse organisaties.
Wat bepaalt uiteindelijk de kwaliteit van AI-gegenereerde kandidaatmatches?
De kwaliteit van AI-gegenereerde kandidaatmatches wordt primair bepaald door de kwaliteit van de input: hoe nauwkeurig de vacature is beschreven, hoe goed de bedrijfscontext is vastgelegd, en hoe helder de uitsluitingscriteria zijn gedefinieerd. Technologie versterkt wat erin gaat, maar compenseert geen slechte intake.
Dit is het meest onderschatte punt in AI-gedreven werving. Organisaties die verwachten dat het systeem vanzelf de juiste kandidaten vindt zonder een grondige intake, worden teleurgesteld. Een generieke vacaturetekst levert generieke matches op. Een gedetailleerd zoekprofiel met cultuurfit-criteria, uitsluitingslijsten en een helder beeld van de organisatie levert matches op die echt relevant zijn.
De Blueprint-module van talentix is precies om die reden het startpunt van het platform. Het systeem zet een intake om in een volledig zoekprofiel, analyseert de organisatie automatisch en brengt het competitieve talentlandschap in kaart. Dat fundament geeft alle vervolgstappen richting.
Naast de intake speelt ook de feedback loop een rol. Elk moment waarop een recruiter een kandidaat afwijst of juist doorschuift, leert het systeem iets over wat wel en niet werkt voor die specifieke organisatie. Systemen die die feedback verwerken, verbeteren hun matchkwaliteit over tijd. Systemen die dat niet doen, blijven statisch.
Kortom: AI talent sourcing is zo goed als de combinatie van databronnen, de scherpte van de intake en de kwaliteit van de feedback die het systeem ontvangt. De technologie doet het werk. De mens bepaalt de richting.
Benieuwd hoe talentix de intake vertaalt naar een volledig zoekprofiel? Bekijk hoe het Blueprint-proces werkt en wat het oplevert voor jouw hiring team.
Auteur: Talentix Redactie, gebaseerd op de headhunter-expertise van Search X
Laatst bijgewerkt: juni 2026
Meer uit deze categorie
Wanneer is AI in recruitment zinvol voor een bedrijf van 200 tot 1000 medewerkers?
Meer dan twee openstaande vacatures? Ontdek wanneer AI in recruitment echt zinvol wordt voor middelgrote bedrijven.
Waarom vertrouwen kandidaten AI-gestuurde sollicitatieprocedures nog niet volledig?
Kandidaten wantrouwen AI in recruitment, niet door irrationaliteit, maar door gebrek aan transparantie. Ontdek waarom.
Hoe verlaagt AI de cost-per-hire bij een krappe arbeidsmarkt?
Krappe arbeidsmarkt, stijgende wervingskosten? AI recruitment verlaagt cost-per-hire drastisch — ontdek hoe.